可观测性工具。
Phoenix(Arize)
1. 简介
为 RAG pipeline 构建基线通常并不困难,但将其增强到适合生产并确保响应质量几乎总是很难。当可选项非常多时,为 RAG 选择正确的工具和参数本身就可能很有挑战。本教程分享一套稳健的工作流,帮助你在构建 RAG 并确保其质量时做出正确选择。
本文介绍如何用一组开源库来评测、可视化和分析你的 RAG。我们将使用:
- Ragas 用于合成测试数据生成和评测
- Arize AI 的 Phoenix 用于 tracing、可视化和聚类分析
- LlamaIndex 用于构建 RAG pipelines
本文将使用 arXiv 上关于 prompt-engineering 的论文数据来构建 RAG pipeline。
ℹ️ 本 notebook 需要 OpenAI API key。
2. 安装依赖并导入库
运行下面的 cell 来安装 Git LFS,我们用它来下载数据集。
!git lfs install
安装并导入 Python 依赖。
!pip install "ragas<0.1.1" pypdf arize-phoenix "openinference-instrumentation-llama-index<1.0.0" "llama-index<0.10.0" pandas
import pandas as pd

# Display the complete contents of DataFrame cells.
pd.set_option("display.max_colwidth", None)
3. 配置你的 OpenAI API Key
如果尚未作为环境变量设置,请设置你的 OpenAI API key。
import os
from getpass import getpass
import openai

if not (openai_api_key := os.getenv("OPENAI_API_KEY")):
    openai_api_key = getpass("🔑 Enter your OpenAI API key: ")
openai.api_key = openai_api_key
os.environ["OPENAI_API_KEY"] = openai_api_key
4. 生成你的合成测试数据集
为评测策划一份黄金测试数据集可能是一个漫长、乏味且昂贵的过程,并不务实——尤其是在起步阶段或数据源不断变化时。这可以通过合成生成高质量数据点来解决,然后再由开发者验证。这可以把策划测试数据的时间和精力减少 90%。
运行下面的 cell,从 arXiv 下载 prompt engineering 论文的 PDF 数据集,并用 LlamaIndex 读取这些文档。
!git clone https://huggingface.co/datasets/vibrantlabsai/prompt-engineering-papers
from llama_index import SimpleDirectoryReader

dir_path = "./prompt-engineering-papers"
reader = SimpleDirectoryReader(dir_path, num_files_limit=2)
documents = reader.load_data()
理想的测试数据集应包含高质量、多样化的数据点,且分布与生产中观察到的相似。Ragas 使用独特的基于进化的合成数据生成范式,生成最高质量的问题,同时也确保生成问题的多样性。Ragas 默认在底层使用 OpenAI 模型,但你可以自由使用任何你选择的模型。让我们用 Ragas 生成 100 个数据点。
from ragas.testset import TestsetGenerator
from langchain_openai import ChatOpenAI
from ragas.embeddings import OpenAIEmbeddings
import openai

TEST_SIZE = 25

# generator with openai models
generator_llm = ChatOpenAI(model="gpt-4o-mini")
critic_llm = ChatOpenAI(model="gpt-4o")
openai_client = openai.OpenAI()
embeddings = OpenAIEmbeddings(client=openai_client)

generator = TestsetGenerator.from_langchain(generator_llm, critic_llm, embeddings)

# generate testset
testset = generator.generate_with_llamaindex_docs(documents, test_size=TEST_SIZE)
test_df = testset.to_pandas()
test_df.head()
你可以按自己的需求更改问题类型分布。现在测试数据集已经准备好,让我们继续用 LlamaIndex 构建一个简单的 RAG pipeline。
5. 用 LlamaIndex 构建你的 RAG 应用
LlamaIndex 是一个易用且灵活的 RAG 应用构建框架。为简单起见,我们使用默认 LLM(gpt-3.5-turbo)和 embedding 模型(openai-ada-2)。
在后台启动 Phoenix,并对你的 LlamaIndex 应用进行插桩,以便 OpenInference spans 和 traces 被发送到 Phoenix 并被收集。OpenInference 是建立在 OpenTelemetry 之上的开放标准,用于捕获和存储 LLM 应用执行。它被设计为一类遥测数据,用于理解 LLM 的执行以及周围的应用上下文,例如从向量存储检索,以及使用搜索引擎或 API 等外部工具。
import phoenix as px
from llama_index import set_global_handler

session = px.launch_app()
set_global_handler("arize_phoenix")
构建你的 query engine。
from llama_index.core import VectorStoreIndex, ServiceContext
from llama_index.embeddings.openai import OpenAIEmbedding


def build_query_engine(documents):
    vector_index = VectorStoreIndex.from_documents(
        documents,
        service_context=ServiceContext.from_defaults(chunk_size=512),
        embed_model=OpenAIEmbedding(),
    )
    query_engine = vector_index.as_query_engine(similarity_top_k=2)
    return query_engine


query_engine = build_query_engine(documents)
如果你检查 Phoenix,应该能看到语料数据被索引时的 embedding spans。导出这些 embeddings 并保存到 DataFrame 中,以便稍后在 notebook 中可视化。
from phoenix.trace.dsl import SpanQuery

client = px.Client()
corpus_df = px.Client().query_spans(
    SpanQuery().explode(
        "embedding.embeddings",
        text="embedding.text",
        vector="embedding.vector",
    )
)
corpus_df.head()
重新启动 Phoenix 以清除累积的 traces。
px.close_app()
session = px.launch_app()
6. 评测你的 LLM 应用
Ragas 提供一份全面的指标列表,可用于按组件和端到端评测 RAG pipelines。
要使用 Ragas,我们首先形成一个评测数据集,包含问题、生成的答案、检索到的 context,以及 ground-truth 答案(给定问题的实际期望答案)。
from datasets import Dataset
from tqdm.auto import tqdm
import pandas as pd


def generate_response(query_engine, question):
    response = query_engine.query(question)
    return {
        "answer": response.response,
        "contexts": [c.node.get_content() for c in response.source_nodes],
    }


def generate_ragas_dataset(query_engine, test_df):
    test_questions = test_df["question"].values
    responses = [generate_response(query_engine, q) for q in tqdm(test_questions)]

    dataset_dict = {
        "question": test_questions,
        "answer": [response["answer"] for response in responses],
        "contexts": [response["contexts"] for response in responses],
        "ground_truth": test_df["ground_truth"].values.tolist(),
    }
    ds = Dataset.from_dict(dataset_dict)
    return ds


ragas_eval_dataset = generate_ragas_dataset(query_engine, test_df)
ragas_evals_df = pd.DataFrame(ragas_eval_dataset)
ragas_evals_df.head()
查看 Phoenix 以浏览你的 LlamaIndex 应用 traces。
print(session.url)
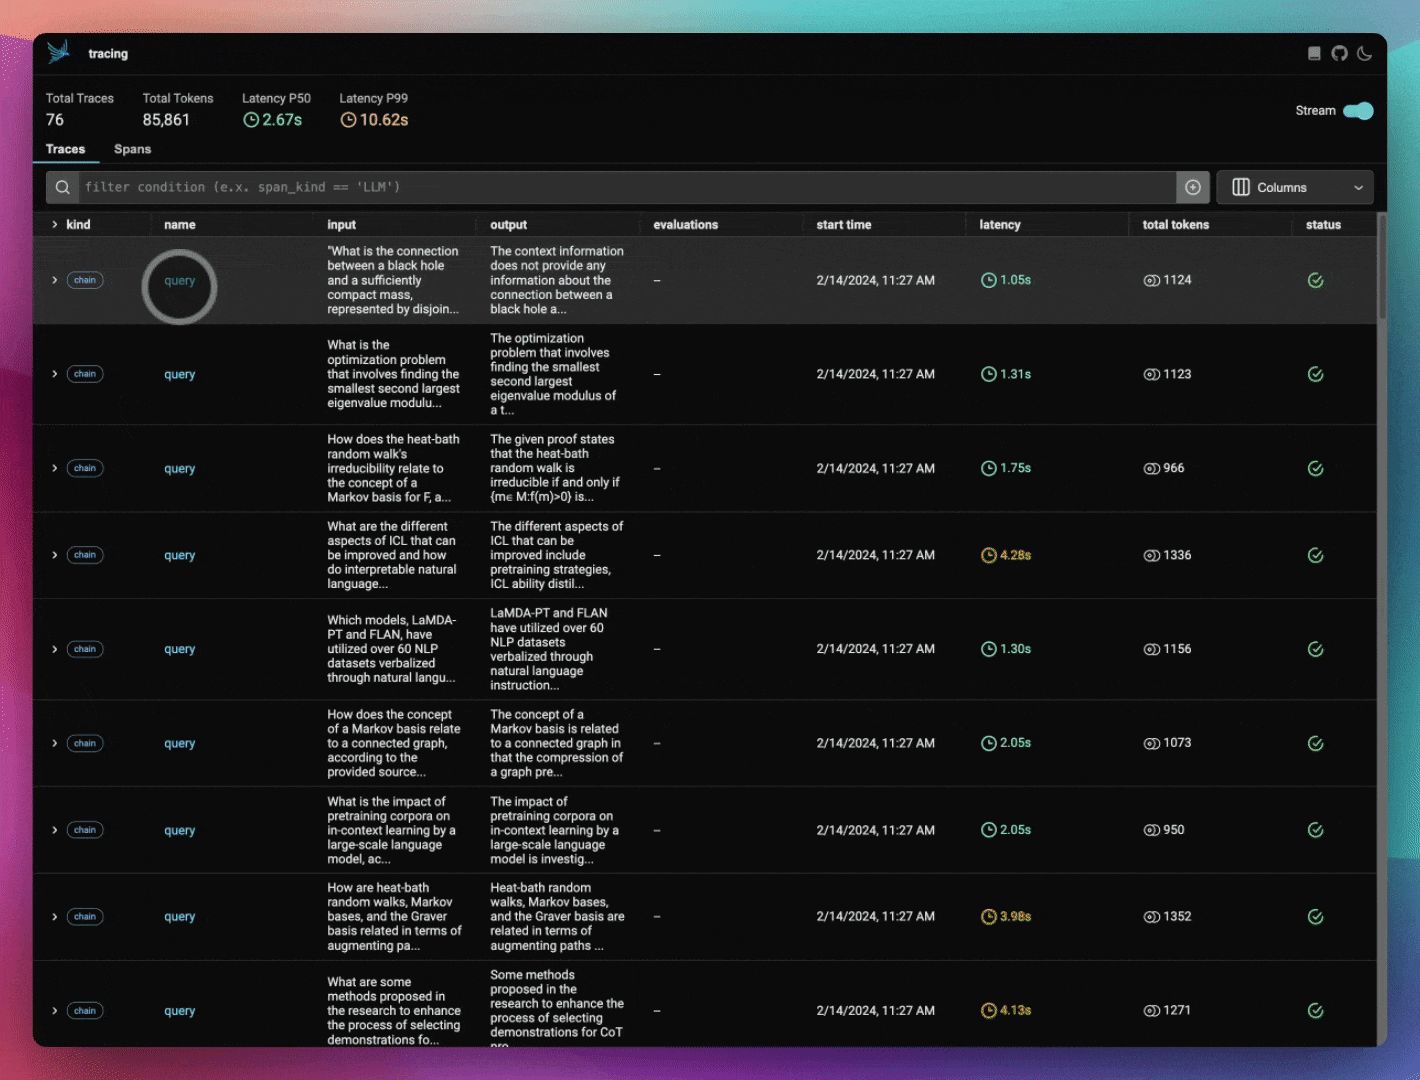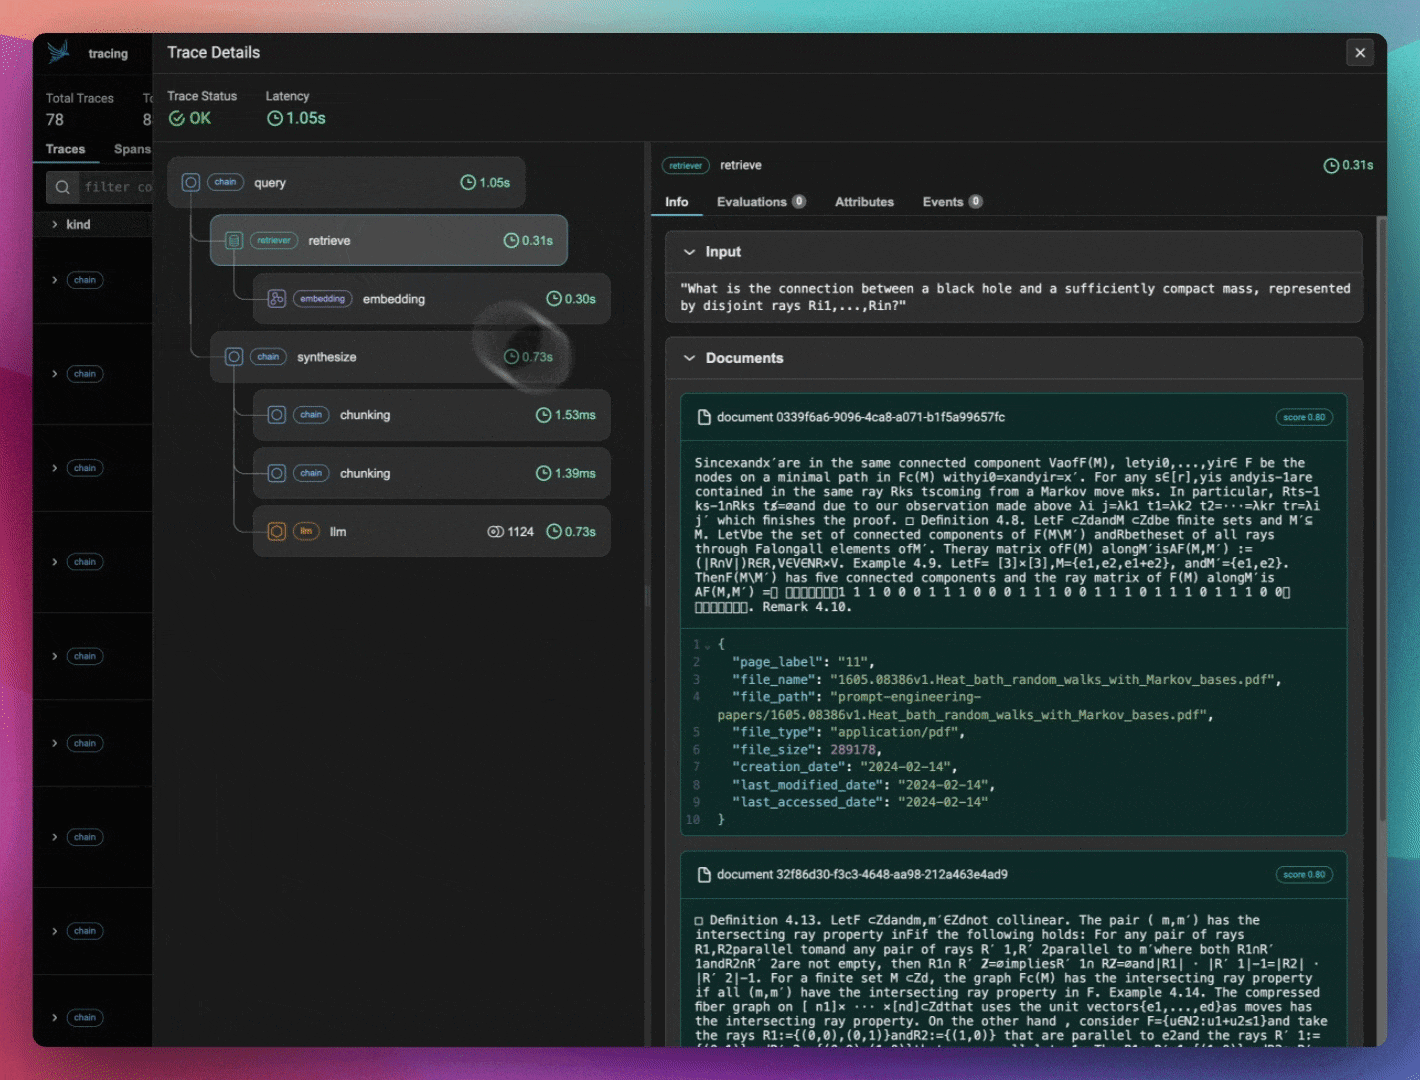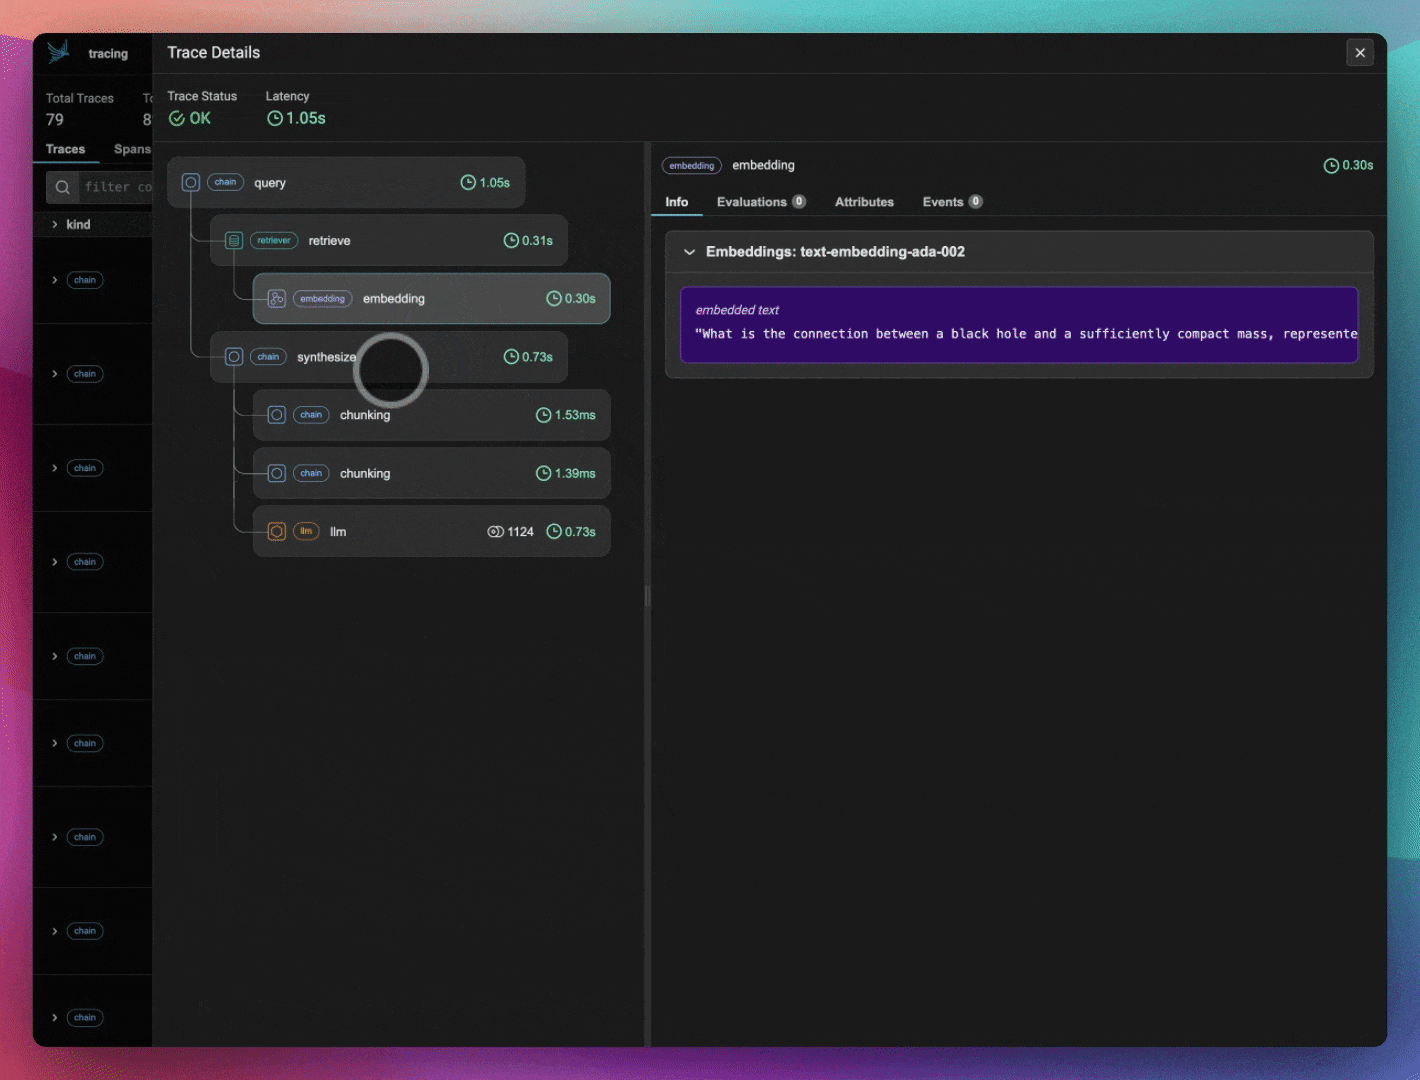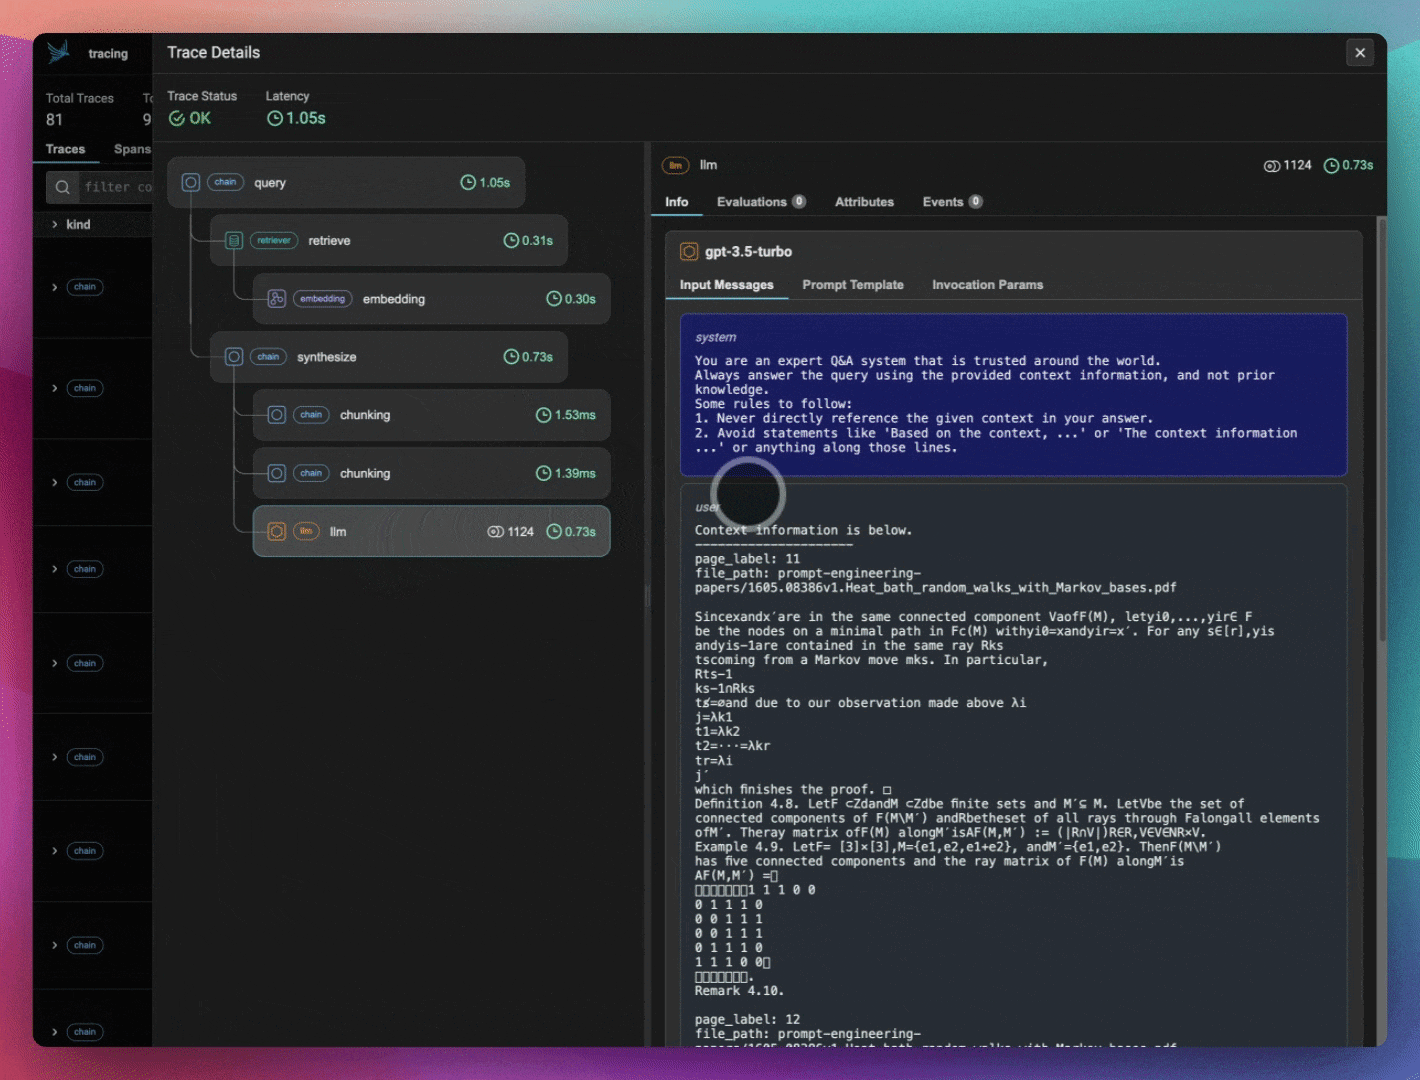
我们保存几个 DataFrame,一个包含稍后要可视化的 embedding 数据,另一个包含我们计划用 Ragas 评测的导出 traces 和 spans。
# dataset containing embeddings for visualization
query_embeddings_df = px.Client().query_spans(
    SpanQuery().explode(
        "embedding.embeddings", text="embedding.text", vector="embedding.vector"
    )
)
query_embeddings_df.head()
from phoenix.session.evaluation import get_qa_with_reference

# dataset containing span data for evaluation with Ragas
spans_dataframe = get_qa_with_reference(client)
spans_dataframe.head()
Ragas 使用 LangChain 来评测你的 LLM 应用数据。让我们用 OpenInference 对 LangChain 进行插桩,这样我们就能看到评测 LLM 应用时底层发生了什么。
from openinference.instrumentation.langchain import LangChainInstrumentor

LangChainInstrumentor().instrument()
评测你的 LLM traces,并以 DataFrame 格式查看评测分数。
from ragas import evaluate
from ragas.metrics import (
    faithfulness,
    answer_correctness,
    context_recall,
    context_precision,
)

evaluation_result = evaluate(
    dataset=ragas_eval_dataset,
    metrics=[faithfulness, answer_correctness, context_recall, context_precision],
)
eval_scores_df = pd.DataFrame(evaluation_result.scores)
将评测提交到 Phoenix,以便它们作为 annotations 显示在你的 spans 上。
from phoenix.trace import SpanEvaluations

# Assign span ids to your ragas evaluation scores (needed so Phoenix knows where to attach the spans).
eval_data_df = pd.DataFrame(evaluation_result.dataset)
assert eval_data_df.question.to_list() == list(
    reversed(spans_dataframe.input.to_list())  # The spans are in reverse order.
), "Phoenix spans are in an unexpected order. Re-start the notebook and try again."
eval_scores_df.index = pd.Index(
    list(reversed(spans_dataframe.index.to_list())), name=spans_dataframe.index.name
)

# Log the evaluations to Phoenix.
for eval_name in eval_scores_df.columns:
    evals_df = eval_scores_df[[eval_name]].rename(columns={eval_name: "score"})
    evals = SpanEvaluations(eval_name, evals_df)
    px.Client().log_evaluations(evals)
如果你查看 Phoenix,会看到 Ragas 评测作为 annotations 显示在你的应用 spans 上。
print(session.url)
7. 可视化并分析你的 Embeddings
Embeddings 编码检索文档和用户查询的含义。它们不仅是 RAG 系统的必要部分,而且对理解和调试 LLM 应用性能极为有用。
Phoenix 从你的 RAG 应用获取高维 embeddings,降低其维度,并将它们聚类成语义上有意义的数据组。然后你可以选择自己的指标(例如 Ragas 计算的 faithfulness 或 answer correctness),以直观检查应用性能并找出有问题的聚类。这种方法的优势在于,它为数据中细粒度但有意义的子集提供指标,帮助你分析局部而非仅仅全局的数据集表现。它也有助于直观理解你的 LLM 应用难以回答哪类查询。
我们将把 Phoenix 重新启动为 embedding 可视化器,以检查应用在测试数据集上的表现。
query_embeddings_df = query_embeddings_df.iloc[::-1]
assert ragas_evals_df.question.tolist() == query_embeddings_df.text.tolist()
assert test_df.question.tolist() == ragas_evals_df.question.tolist()
query_df = pd.concat(
    [
        ragas_evals_df[["question", "answer", "ground_truth"]].reset_index(drop=True),
        query_embeddings_df[["vector"]].reset_index(drop=True),
        test_df[["evolution_type"]],
        eval_scores_df.reset_index(drop=True),
    ],
    axis=1,
)
query_df.head()
query_schema = px.Schema(
    prompt_column_names=px.EmbeddingColumnNames(
        raw_data_column_name="question", vector_column_name="vector"
    ),
    response_column_names="answer",
)
corpus_schema = px.Schema(
    prompt_column_names=px.EmbeddingColumnNames(
        raw_data_column_name="text", vector_column_name="vector"
    )
)
# relaunch phoenix with a primary and corpus dataset to view embeddings
px.close_app()
session = px.launch_app(
    primary=px.Dataset(query_df, query_schema, "query"),
    corpus=px.Dataset(corpus_df.reset_index(drop=True), corpus_schema, "corpus"),
)
启动 Phoenix 后,你可以通过以下步骤用自己选择的指标可视化数据:
- 选择
vectorembedding, - 选择
Color By > dimension,然后选择你想用来给数据上色的字段,例如按 Ragas 评测分数如 faithfulness 或 answer correctness 上色, - 从
metric下拉菜单中选择你想要的指标,以按聚类查看聚合指标。
8. 回顾
恭喜!你用 Ragas 和 Phoenix 构建并评测了一个 LlamaIndex query engine。让我们回顾学到的内容:
- 用 Ragas,你引导生成了测试数据集,并计算了 faithfulness 和 answer correctness 等指标来评测 LlamaIndex query engine。
- 用 OpenInference,你对 query engine 进行了插桩,因此可以观察 LlamaIndex 和 Ragas 的内部工作。
- 用 Phoenix,你收集了 spans 和 traces,导入评测以便轻松检查,并可视化嵌入的查询和检索到的文档,以识别表现不佳的区域。
本 notebook 只是对 Ragas 和 Phoenix 能力的介绍。要了解更多,请参见 Ragas 和 Phoenix 文档。
如果你喜欢本教程,请在 GitHub 上留下 ⭐:
LangSmith
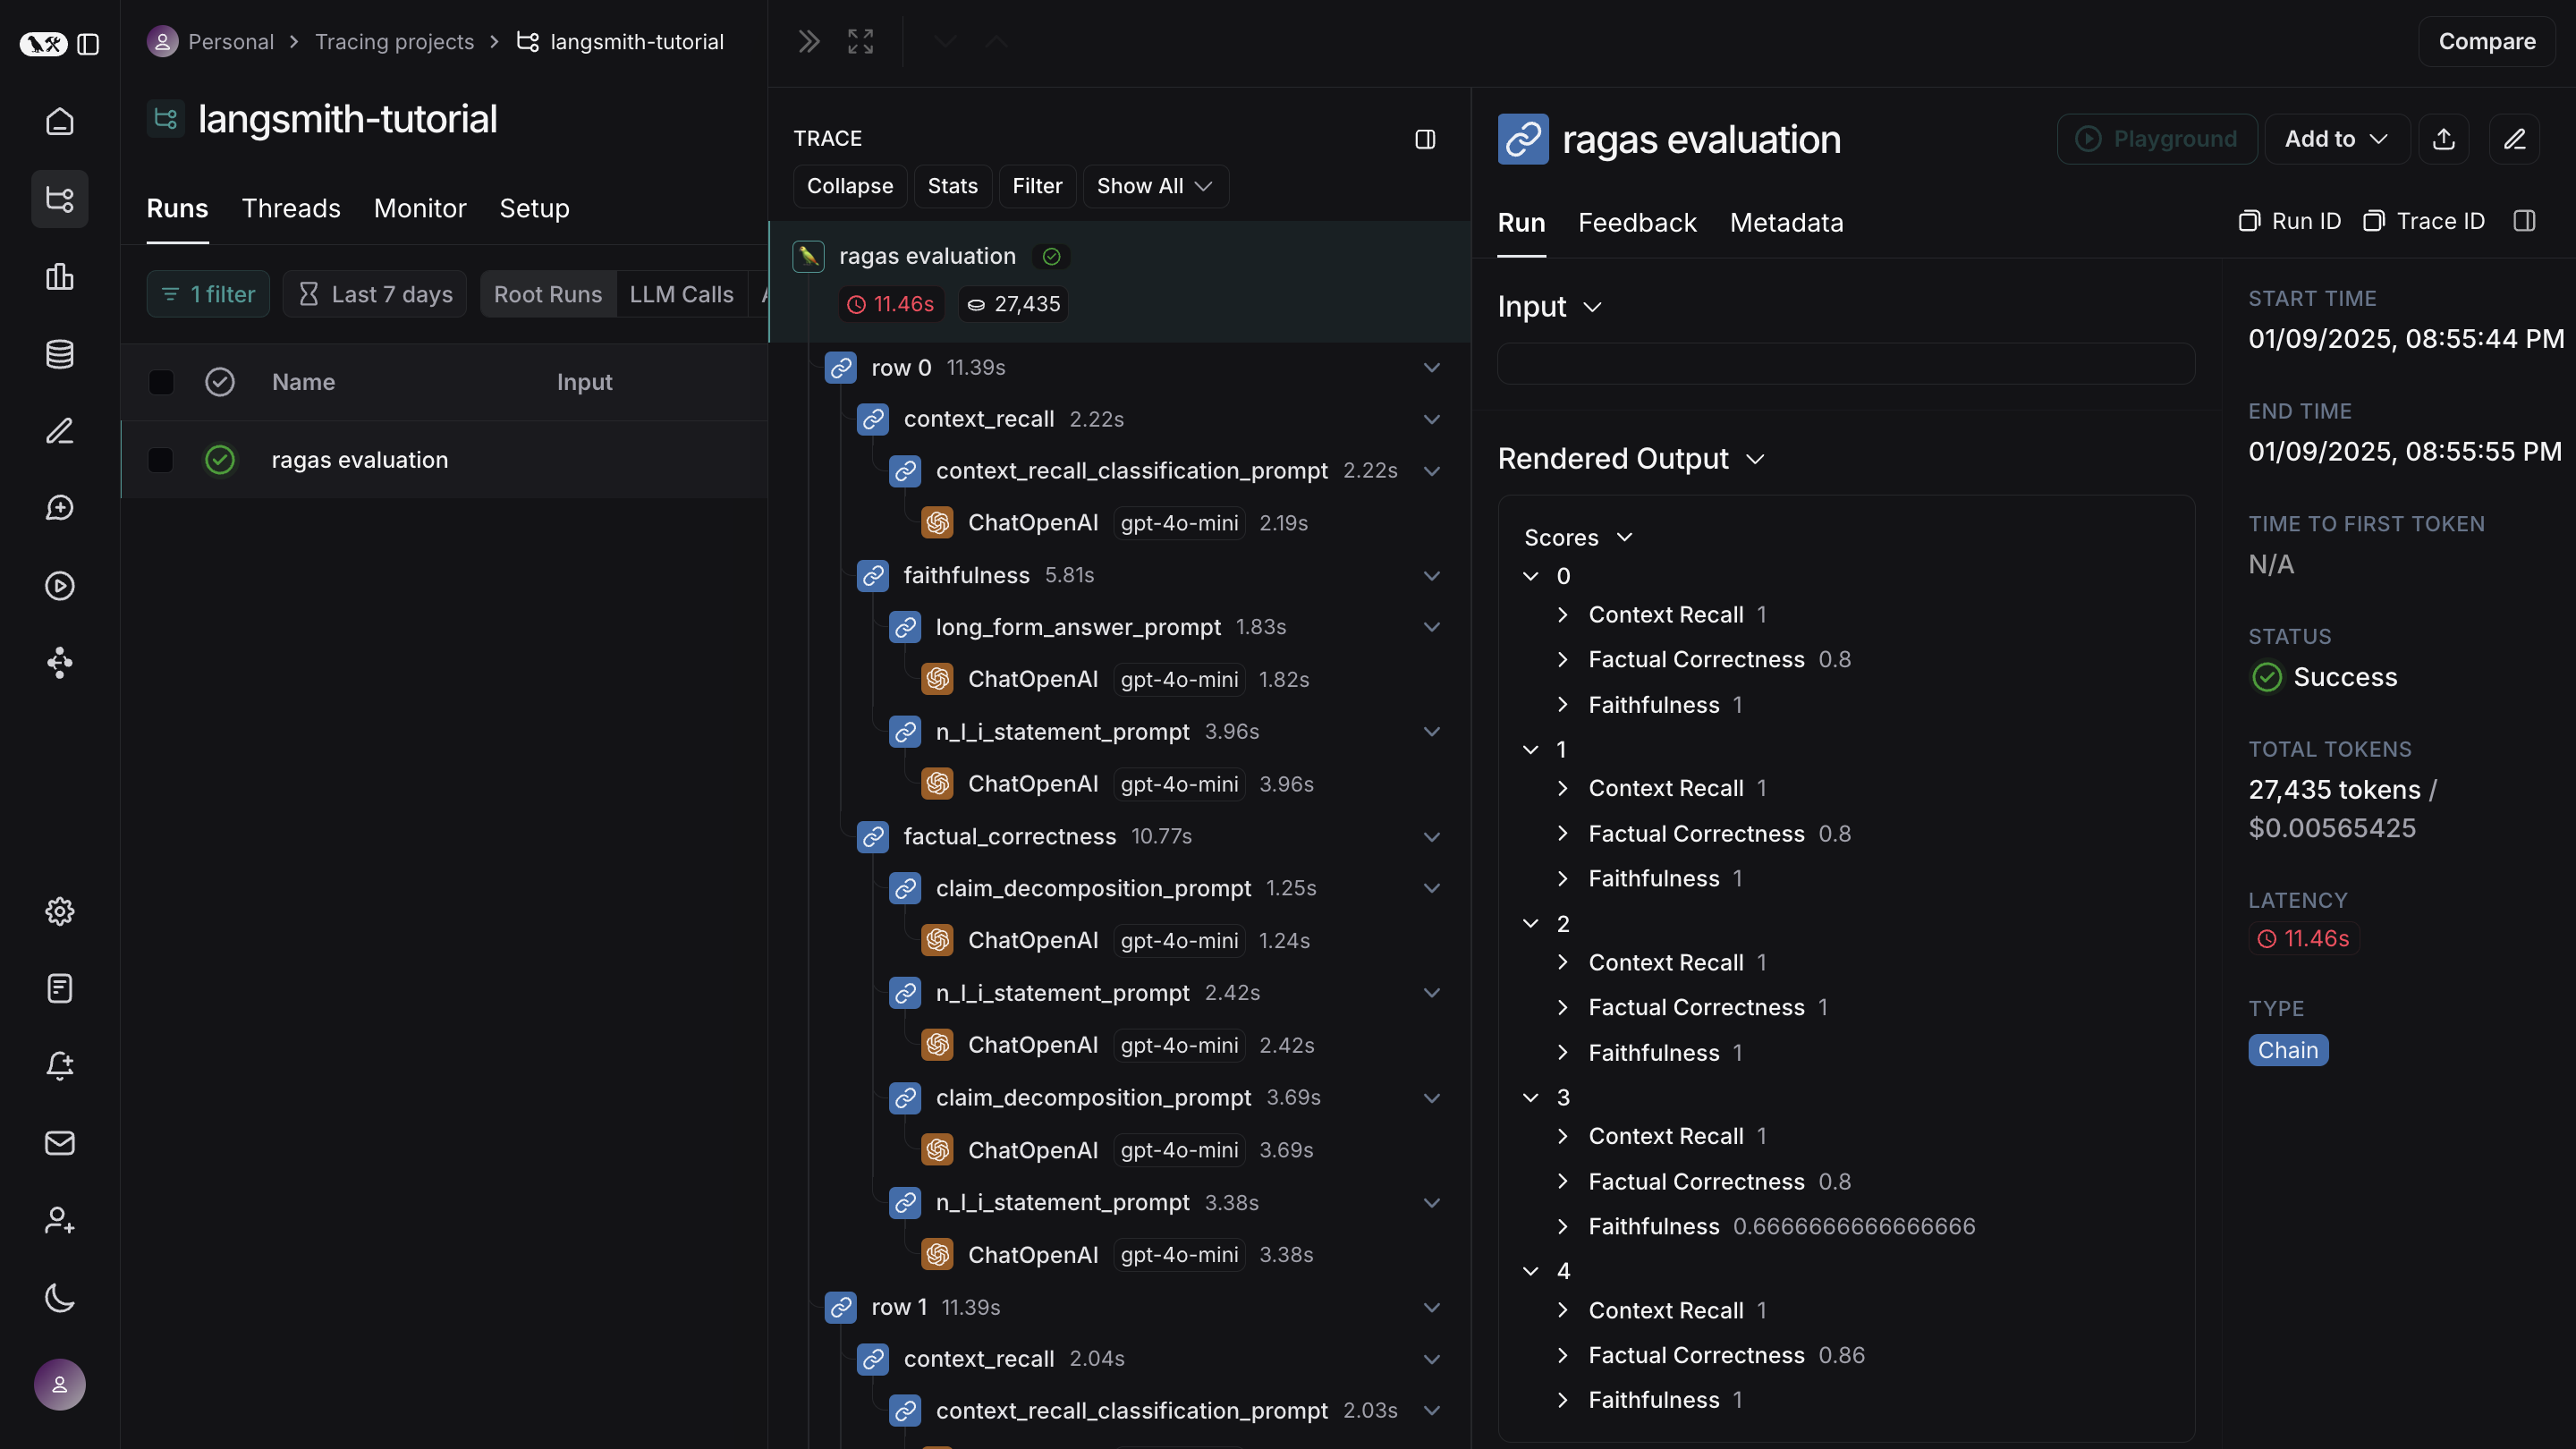
LangSmith 是一款旨在增强利用大语言模型(LLM)的应用开发与部署的高级工具。它提供用于 tracing、分析和优化 LLM 工作流的综合框架,使开发者更容易管理应用中的复杂交互。
本教程说明如何用 LangSmith 记录 Ragas 评测的 traces。由于 Ragas 建立在 LangChain 之上,你只需设置 LangSmith,它就会自动处理 traces 的记录。
1. 设置 LangSmith
要设置 LangSmith,请确保设置以下环境变量(更多细节参见 LangSmith 文档):
export LANGCHAIN_TRACING_V2=true
export LANGCHAIN_ENDPOINT=https://api.smith.langchain.com
export LANGCHAIN_API_KEY=<your-api-key>
export LANGCHAIN_PROJECT=<your-project>  # Defaults to "default" if not set
2. 获取数据集
在创建评测数据集或评测实例时,确保术语与 SingleTurnSample 或 MultiTurnSample 中使用的 schema 匹配。
from ragas import EvaluationDataset


dataset = [
    {
        "user_input": "Which CEO is widely recognized for democratizing AI education through platforms like Coursera?",
        "retrieved_contexts": [
            "Andrew Ng, CEO of Landing AI, is known for his pioneering work in deep learning and for democratizing AI education through Coursera."
        ],
        "response": "Andrew Ng is widely recognized for democratizing AI education through platforms like Coursera.",
        "reference": "Andrew Ng, CEO of Landing AI, is known for democratizing AI education through Coursera.",
    },
    {
        "user_input": "Who is Sam Altman?",
        "retrieved_contexts": [
            "Sam Altman, CEO of OpenAI, has advanced AI research and advocates for safe, beneficial AI technologies."
        ],
        "response": "Sam Altman is the CEO of OpenAI and advocates for safe, beneficial AI technologies.",
        "reference": "Sam Altman, CEO of OpenAI, has advanced AI research and advocates for safe AI.",
    },
    {
        "user_input": "Who is Demis Hassabis and how did he gain prominence?",
        "retrieved_contexts": [
            "Demis Hassabis, CEO of DeepMind, is known for developing systems like AlphaGo that master complex games."
        ],
        "response": "Demis Hassabis is the CEO of DeepMind, known for developing systems like AlphaGo.",
        "reference": "Demis Hassabis, CEO of DeepMind, is known for developing AlphaGo.",
    },
    {
        "user_input": "Who is the CEO of Google and Alphabet Inc., praised for leading innovation across Google's product ecosystem?",
        "retrieved_contexts": [
            "Sundar Pichai, CEO of Google and Alphabet Inc., leads innovation across Google's product ecosystem."
        ],
        "response": "Sundar Pichai is the CEO of Google and Alphabet Inc., praised for leading innovation across Google's product ecosystem.",
        "reference": "Sundar Pichai, CEO of Google and Alphabet Inc., leads innovation across Google's product ecosystem.",
    },
    {
        "user_input": "How did Arvind Krishna transform IBM?",
        "retrieved_contexts": [
            "Arvind Krishna, CEO of IBM, transformed the company by focusing on cloud computing and AI solutions."
        ],
        "response": "Arvind Krishna transformed IBM by focusing on cloud computing and AI solutions.",
        "reference": "Arvind Krishna, CEO of IBM, transformed the company through cloud computing and AI.",
    },
]

evaluation_dataset = EvaluationDataset.from_list(dataset)
3. Tracing ragas metrics
在你的数据集上运行 Ragas 评测,traces 会出现在 LangSmith dashboard 中指定的项目名或 "default" 下。
from ragas import evaluate
from ragas.llms import LangchainLLMWrapper
from langchain_openai import ChatOpenAI
from ragas.metrics import LLMContextRecall, Faithfulness, FactualCorrectness

llm = ChatOpenAI(model="gpt-4o-mini")
evaluator_llm = LangchainLLMWrapper(llm)

result = evaluate(
    dataset=evaluation_dataset,
    metrics=[LLMContextRecall(), Faithfulness(), FactualCorrectness()],
    llm=evaluator_llm,
)

result
输出
Evaluating:   0%|          | 0/15 [00:00<?, ?it/s]

{'context_recall': 1.0000, 'faithfulness': 0.9333, 'factual_correctness': 0.8520}
4. LangSmith Dashboard